June 8, 2026 · Von ChefExtract Team
Wie KI Rezepte aus Kochvideos extrahiert
Hinter jedem „Link einfügen, Rezept erhalten“-Button steckt eine mehrschichtige KI-Pipeline, die gleichzeitig Bildunterschrift, Video und Audio liest. Hier ist, was wirklich passiert, wenn du ein Rezept extrahierst.
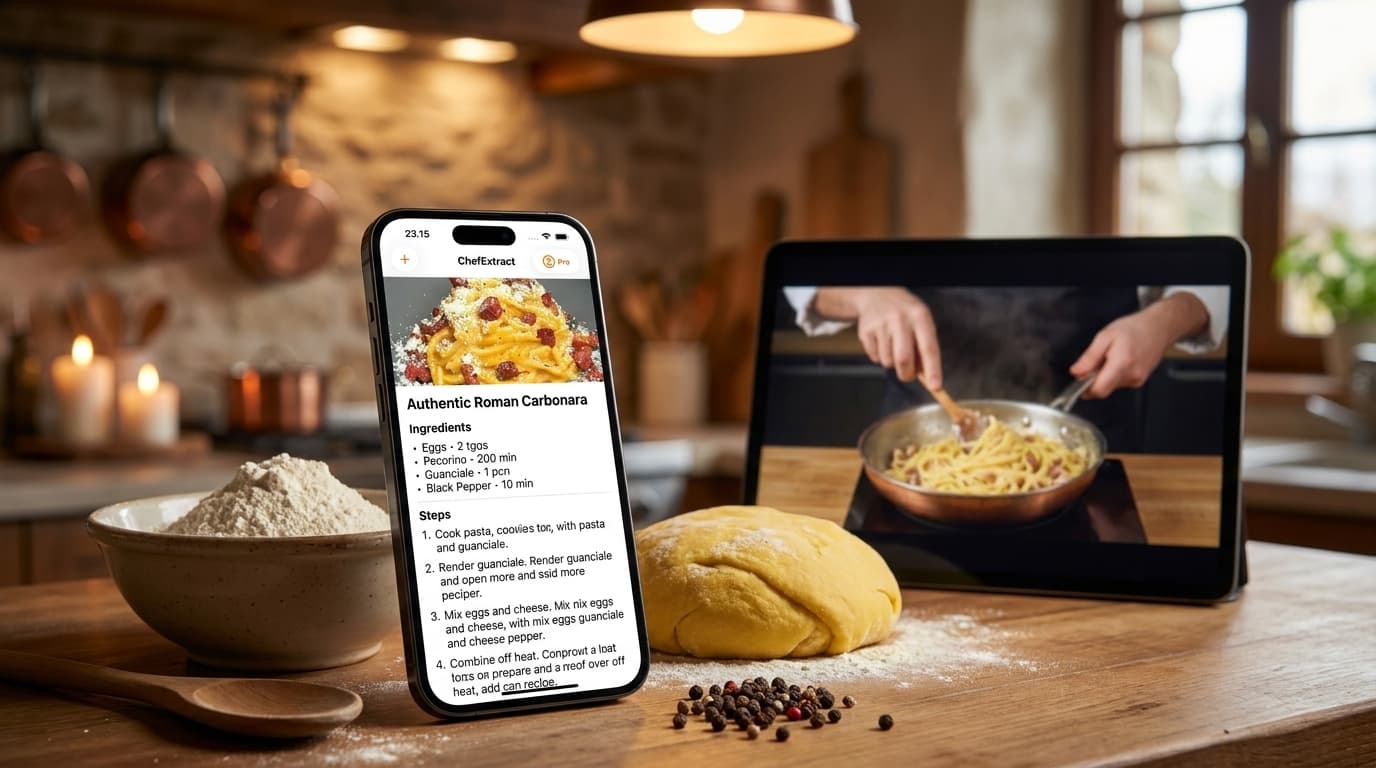
Du fügst einen TikTok-Link ein, tippst auf einen Button, und 20 Sekunden später hast du eine saubere Zutatenliste mit nummerierten Schritten. Es sieht einfach aus. Unter der Oberfläche verbirgt sich eine Pipeline mit mehreren klar getrennten Phasen, die jeweils einen anderen Teil des Problems lösen.
Zu verstehen, wie es funktioniert, hilft dir, es besser zu nutzen — einschließlich des Wissens, wann du ein sauberes Ergebnis erwarten kannst, wann du etwas rechnen solltest, das Nachbearbeitung braucht, und warum manche Videos gut extrahiert werden, während andere dünn zurückkommen.
Warum die Videorezeptextraktion schwieriger ist, als sie aussieht
Ein Rezept aus einem Kochvideo zu extrahieren ist nicht dasselbe wie Text von einer Rezeptwebsite zu kopieren. Eine Rezeptwebsite hat strukturierte Daten: Die Zutatenliste steckt in einem Container, die Schritte in einem Container, der Titel in einem Heading-Tag. Ein Extraktor kann das in Millisekunden mit hoher Sicherheit lesen.
Ein Kochvideo hat diese Struktur nicht. Die Rezeptinformationen sind gleichzeitig auf drei verschiedene Kanäle verteilt:
- Vom Ersteller laut gesprochene Worte („einen halben Teelöffel Salz dazugeben“)
- Ins Video eingeblendete Textüberlagerungen („½ TL Salz“, die 0,4 Sekunden lang erscheint)
- Die geschriebene Bildunterschrift oder Beschreibung („volles Rezept im Bio 🙏“)
Jeder Kanal ist für sich unzuverlässig. Das Audio kann unklar oder von Musik überlagert sein. Die Textüberlagerungen können stilisiert oder flüchtig sein. Die Bildunterschrift kann leer sein. Ein guter Extraktor liest alle drei und kombiniert sie zu einem kohärenten Rezept.
Schicht 1: Bildunterschrift und Beschreibung
Das Erste, was ein Extraktor liest, ist das Einfachste: der Text. Bildunterschrift auf Instagram oder TikTok, Beschreibung auf YouTube, Beitragstext auf Facebook.
Für Plattformen, auf denen Ersteller das Rezept im Text ausschreiben — YouTube insbesondere, wo vollständige beschreibungsbasierte Rezepte Standard sind — reicht diese Schicht allein oft aus. Der Extraktor analysiert den Text, identifiziert die Zutatenlistenstruktur (meist ein Muster wie „Menge + Einheit + Zutatennname“), identifiziert die Schritte und stellt das Ergebnis zusammen.
Wenn die Bildunterschrift reichhaltig ist, geht die Extraktion schnell und ist hochgenau, weil es sich um strukturiertes Textparsing handelt, nicht um Interpretation.
Wenn die Bildunterschrift spärlich ist (nur Hashtags, eine einzeilige Beschreibung oder leer), geht der Extraktor zu den nächsten Schichten über.
Schicht 2: Texterkennung auf dem Bildschirm (OCR)
Viele Kochersteller fügen ihren Videos Textüberlagerungen hinzu: Zutatenmenge, Technikhinweise, Temperaturangaben, Zeithinweise. „1 Tasse Mehl.“ „175 °C.“ „Großzügig würzen.“ Diese erscheinen jeweils für einen Bruchteil einer Sekunde und sind beim Anschauen leicht zu verpassen, aber ein KI-Modell verarbeitet jeden einzelnen Frame.
Dafür kommt optische Zeichenerkennung (OCR) in Kombination mit einem Vision-Modell zum Einsatz, das den Kontext des Gelesenen versteht. Das Modell extrahiert nicht einfach Buchstaben — es versteht, dass „2 EL Olivenöl“ ein Zutateneintrag ist, keine zufällige Zeichenkette.
Einige Faktoren beeinflussen die OCR-Genauigkeit:
Schriftart und Kontrast: Weißer Text auf dunklem Hintergrund wird zuverlässig gelesen. Schreibschriften, Neonfarben auf unruhigem Hintergrund oder Text mit starkem Schlagschatten werden weniger zuverlässig gelesen.
Animationsgeschwindigkeit: Text, der 1–2 Sekunden eingeblendet bleibt, wird sauber extrahiert. Text, der nur 0,2 Sekunden aufblitzt, wird möglicherweise übersehen oder nur teilweise erfasst.
Überlagerungs-Stiltrends: Es gibt eine TikTok-Ästhetik, bei der Zutatentextüberlagerungen dekorative Handschriftfonts über dem Kochvideo verwenden. Diese sehen gut aus und werden inkonsistent extrahiert. Je stilisierter die Schrift, desto geringer die OCR-Genauigkeit.
Schicht 3: Audiotranskription
Die dritte Quelle ist die Tonspur — konkret der Voiceover-Kommentar des Erstellers. „Eine halbe Zwiebel würfeln und in Olivenöl etwa fünf Minuten andünsten“ ist nützliche Rezeptinformation, und sie ist oft die vollständigste Quelle: Ein Ersteller, der natürlich spricht, erwähnt mit größerer Wahrscheinlichkeit alle Mengen, als sie alle als Bildschirmtext einzublenden.
Ein Spracherkennungsmodell transkribiert das Audio, und dann analysiert ein Sprachmodell das Transkript, um rezeptrelevante Inhalte zu identifizieren: Zutatennennungen, Mengenangaben, Technikbeschreibungen, Zeithinweise.
Die Audioextraktionsqualität wird beeinflusst durch:
Signal-Rausch-Verhältnis: Wenn die Hintergrundmusik leiser als die Stimme ist, ist die Transkription zuverlässig. Wenn Hintergrundmusik dominiert (eine verbreitete TikTok-Ästhetik), ist das Stimmsignal schwerer zu isolieren und die Transkriptionsgenauigkeit sinkt.
Narrationsstil: Manche Ersteller kommentieren explizit („zwei Esslöffel Butter dazugeben“). Andere sprechen locker („etwas Butter dazu, nicht zu viel“). Der erste Fall extrahiert gut; der zweite extrahiert als ungefähre Angabe.
Tempo und Klarheit: Schnell sprechende Ersteller mit regionalem Akzent oder umgangssprachlicher Ausdrucksweise transkribieren weniger genau als bedächtiges, deutliches Kommentieren.
Die drei Schichten zu einem Rezept zusammenführen
Sobald der Extraktor Ergebnisse aus Bildunterschrift, OCR und Audio hat, muss er sie zu einem einzigen kohärenten Rezept zusammenführen. Hier übernimmt ein Sprachmodell die Synthesearbeit.
Das Modell betrachtet möglicherweise überlappende oder widersprüchliche Informationen aus den Quellen und löst diese auf:
- Wenn die Bildunterschrift „2 Tassen Mehl“ und das Audio „ungefähr zwei Tassen“ sagt, ist der kanonische Wert „2 Tassen“.
- Wenn die Bildunterschrift leer ist, das Audio „eine Handvoll Kirschtomaten“ sagt und der Bildschirmtext „12 Kirschtomaten“ zeigt, verwendet das Modell den spezifischeren Wert.
- Wenn eine Zutat nur im Bildschirmtext erscheint, aber weder in der Bildunterschrift noch im Audio erwähnt wird, wird sie allein auf Basis der OCR aufgenommen.
- Wenn zwei Quellen sich widersprechen (Bildunterschrift: „1 EL Olivenöl“, Audio: „3 Esslöffel“), entscheidet das Modell anhand von Kontexthinweisen — in der Regel die spezifischere Quelle oder diejenige, die konsistenter auftritt.
Das Ergebnis ist ein strukturiertes Rezept: Titel, Zutatenliste mit Mengen und Einheiten, geordnete Schritte und ein Link zur Originalquelle.
Warum manche Extraktionen besser ausfallen als andere
Jetzt, da die Pipeline klar ist, ergeben die Fehlermodi mehr Sinn:
Spärliche Bildunterschrift + schlechtes Audio + stilisierte Überlagerungen: Alle drei Schichten sind gleichzeitig beeinträchtigt. Der Extraktor hat wenig zuverlässige Daten und gibt ein dünnes oder unvollständiges Ergebnis zurück. Das ist der schlimmste Fall — stark stilisierte TikToks mit lauter Musik und keiner Bildunterschrift.
Nur-Bildunterschrift-Extraktionen: Wenn die Bildunterschrift reichhaltig und gut strukturiert ist, kann der Extraktor Video und Audio vollständig ignorieren. Diese sind am schnellsten und genauesten. Häufig auf YouTube und bei Instagram-Beiträgen, wo Ersteller das vollständige Rezept ausschreiben.
OCR-abhängige Extraktionen: Wenn die Bildunterschrift dünn ist, aber der Bildschirmtext klar und gut getaktet, übernimmt die OCR die Hauptarbeit. Die Genauigkeit hängt von der Schriftwahl und der Animationsgeschwindigkeit ab.
Audioabhängige Extraktionen: Wenn Bildunterschrift und Überlagerungen spärlich sind, der Ersteller aber klar kommentiert, liefert die Sprachtranskription den Großteil des Rezepts. Die Genauigkeit hängt von der Stimmklarheit und dem Hintergrundrauschen ab.
Das zu verstehen hilft dir, das Ergebnis vorherzusagen: Ein unübersichtliches, hochproduktives TikTok ist eine schwierigere Extraktion als ein klar kommentiertes YouTube-Tutorial mit vollständiger Beschreibung.
Was die Extraktion nicht tut
Ein paar Dinge, die es wert sind, klar zu sagen:
Sie erfindet keine fehlenden Informationen. Ein verantwortungsvoller Rezeptextraktor rät keine Mengen oder Schritte hinzu, die in keiner der drei Quellen vorkamen. Wenn das Rezept im Quellvideo tatsächlich unvollständig ist, ist die Extraktion ebenfalls unvollständig — er erfindet keine plausibel klingenden Werte.
Sie verändert das Rezept nicht. Der Extraktor strukturiert, was im Quellmaterial steht. Er verbessert, passt nicht an und kommentiert nicht. Wenn der Ersteller „nach Belieben würzen“ sagte, steht im Schritt „nach Belieben würzen“. Wenn eine genaue Menge genannt wurde, wird diese beibehalten.
Er hat keinen Zugriff auf private Inhalte. Wenn ein Reel von einem privaten Account stammt oder ein Gruppenbeitrag, dessen Mitglied du nicht bist, kann der Extraktor darauf nicht zugreifen — und er fragt nicht nach deinen Anmeldedaten, um es zu versuchen.
Wenn die KI daneben liegt: der Bearbeitungs-Workflow
Keine Pipeline ist perfekt. Die Extraktionsgenauigkeit bei klaren, strukturierten Quellen (YouTube mit vollständiger Beschreibung, Instagram mit Bildunterschriften-Rezept) ist sehr hoch. Bei unübersichtlichen Quellen (stilisierte TikToks mit lauter Musik) ist sie geringer.
Wenn eine Extraktion Fehler enthält:
- Das Rezept in ChefExtract öffnen. Jedes Feld — Titel, jede Zutat, jeder Schritt — ist bearbeitbar.
- Fehler korrigieren. Eine fehlende Menge ergänzen, eine Angabe korrigieren, einen Schritt vervollständigen, der nur teilweise erfasst wurde.
- Speichern. Das korrigierte Rezept ist jetzt dauerhaft und korrekt.
Eine teilweise korrekte Extraktion zu bearbeiten ist fast immer schneller als von Grund auf abzutippen. Das Ziel der Extraktion ist nicht, menschliches Urteilsvermögen zu ersetzen — sondern 80–90 % der Arbeit zu erledigen, damit du korrigierst statt schreibst.
Der Stand der Technik im Jahr 2026
Multimodale KI — Modelle, die gleichzeitig Text, Bild und Audio lesen — hat sich deutlich verbessert. Ein heute gebauter Rezeptextraktor hat Zugang zu einer Spracherkennungsgenauigkeit, die noch vor wenigen Jahren kommerzielle Infrastruktur erfordert hätte, und Vision-Modellen, die Bildschirmtext unter den meisten Bedingungen mit hoher Genauigkeit lesen können.
Die schwierigen Fälle bleiben: sehr schnelle Textüberlagerungen, laute Hintergrundmusik, keine Bildunterschrift und hochproduzierter visueller Stil. Das sind keine gelösten Probleme. Ehrliche Extraktoren zeigen an, wenn ein Ergebnis unsicher ist; unehrliche füllen Lücken mit plausibel klingenden, aber erfundenen Inhalten.
Wenn du sehen möchtest, wie die Extraktion bei verschiedenen Quelltypen abschneidet, sieh dir Beispielrezepte an, die aus echten Kochinhalten extrahiert wurden. Oder probiere es an einem Video aus, das du schon lange kochen wolltest:
Für den praktischen Workflow auf jeder Plattform — Instagram, TikTok, YouTube, Facebook und Pinterest — sieh dir den vollständigen Leitfaden zum Speichern von Rezepten aus sozialen Medien an.
ChefExtract kostenlos testen
Speichere dein erstes Rezept in Sekunden. Kein Konto nötig.