June 8, 2026 · Par ChefExtract Team
Comment l'IA extrait les recettes des vidéos de cuisine
Derrière chaque bouton « coller un lien, obtenir une recette » se cache un pipeline IA multicouche qui lit simultanément la légende, la vidéo et l'audio. Voici ce qui se passe réellement quand vous extrayez une recette.
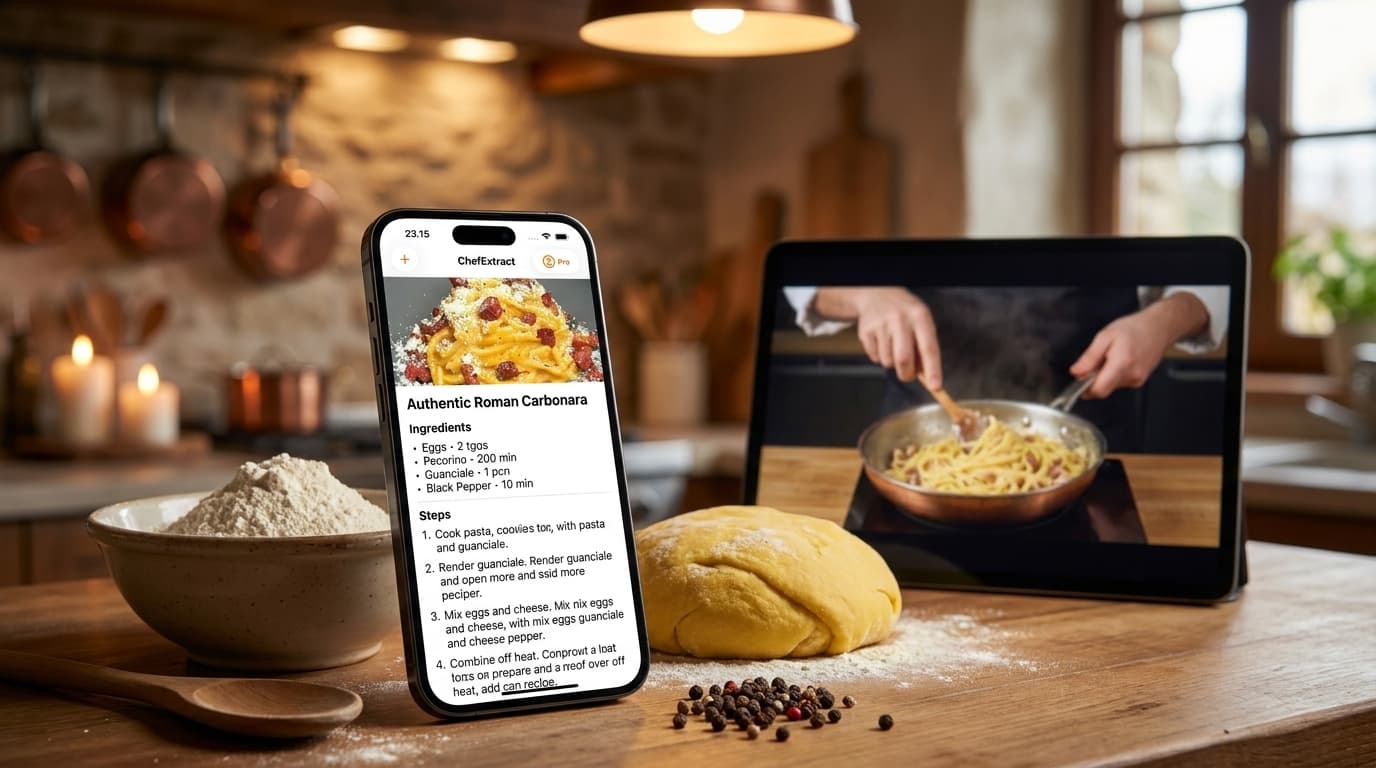
Vous collez un lien TikTok, appuyez sur un bouton, et 20 secondes plus tard vous avez une liste d'ingrédients propre avec des étapes numérotées. Ça paraît simple. En coulisse, c'est un pipeline avec plusieurs étapes distinctes, chacune résolvant une partie différente du problème.
Comprendre comment ça fonctionne vous aide à mieux l'utiliser — notamment à savoir quand attendre une extraction propre, quand vous attendre à quelque chose qui nécessite des retouches, et pourquoi certaines vidéos s'extraient bien tandis que d'autres reviennent incomplètes.
Pourquoi l'extraction de recettes vidéo est plus difficile qu'il n'y paraît
Extraire une recette d'une vidéo de cuisine n'est pas la même chose que copier du texte d'un site de recettes. Un site de recettes a des données structurées : la liste des ingrédients est dans un conteneur, les étapes sont dans un conteneur, le titre est dans une balise de titre. Un extracteur peut lire tout ça en quelques millisecondes avec une grande fiabilité.
Une vidéo de cuisine n'a aucune de ces structures. Les informations de la recette sont dispersées simultanément sur trois canaux différents :
- Les mots prononcés à voix haute par le créateur (« ajoutez une demi-cuillère à café de sel »)
- Les textes superposés ajoutés à la vidéo (« 1/2 cc sel » apparaissant pendant 0,4 seconde)
- La légende ou la description écrite (« recette complète en bio 🙏 »)
Chaque canal est peu fiable seul. L'audio peut être peu clair ou noyé par la musique. Les textes superposés peuvent être stylisés ou rapides. La légende peut être vide. Un bon extracteur lit les trois et les combine en une recette cohérente.
Couche 1 : la légende et la description
La première chose qu'un extracteur lit est la plus facile : le texte. La légende sur Instagram ou TikTok, la description sur YouTube, le texte du post sur Facebook.
Pour les plateformes où les créateurs écrivent la recette en texte — YouTube en particulier, où les recettes en format description complète sont standard — cette couche seule est souvent suffisante. L'extracteur analyse le texte, identifie la structure de la liste des ingrédients (généralement un motif comme « quantité + unité + nom de l'ingrédient »), identifie les étapes et assemble le résultat.
Quand la légende est riche, l'extraction est rapide et très précise car c'est de l'analyse de texte structuré, pas de l'interprétation.
Quand la légende est creuse (juste des hashtags, une seule phrase, ou vide), l'extracteur passe aux couches suivantes.
Couche 2 : reconnaissance de texte à l'écran (OCR)
De nombreux créateurs culinaires ajoutent des textes superposés à leurs vidéos : quantités d'ingrédients, notes de technique, températures, repères de timing. « 1 tasse de farine. » « 180°C. » « Assaisonnez généreusement. » Ces éléments apparaissent pendant une fraction de seconde chacun et sont faciles à manquer en regardant la vidéo, mais un modèle IA traite chaque image.
Ceci est géré par la reconnaissance optique de caractères (OCR) combinée à un modèle de vision qui comprend le contexte de ce qu'il lit. Le modèle n'extrait pas seulement des lettres — il comprend que « 2 c. à soupe d'huile d'olive » est une entrée d'ingrédient, pas une chaîne de texte aléatoire.
Plusieurs facteurs affectent la précision de l'OCR :
Police et contraste : le texte blanc sur fond sombre se lit de manière fiable. Les polices manuscrites, les couleurs néon sur des arrière-plans chargés, ou le texte avec de lourdes ombres portées se lisent moins bien.
Vitesse d'animation : le texte qui reste à l'écran 1 à 2 secondes s'extrait proprement. Le texte qui clignote pendant 0,2 seconde peut être manqué ou partiellement lu.
Tendances de style de superposition : il existe une esthétique TikTok où les superpositions d'ingrédients utilisent des polices manuscrites décoratives sur la vidéo de nourriture. Ces styles sont visuellement attrayants mais s'extraient de manière inconstante. Plus la police est stylisée, plus la précision OCR est faible.
Couche 3 : transcription audio
La troisième source est la piste audio — spécifiquement la narration en voix off du créateur. « Émincez un demi-oignon et faites-le revenir dans l'huile d'olive pendant environ cinq minutes » est une information utile pour la recette, et c'est souvent la source la plus complète car un créateur qui parle naturellement est plus susceptible de mentionner toutes les quantités qu'il ne l'est de les écrire toutes dans les textes superposés.
Un modèle de reconnaissance vocale transcrit l'audio, puis un modèle de langage analyse la transcription pour identifier le contenu pertinent pour la recette : mentions d'ingrédients, références à des quantités, descriptions de techniques, repères de timing.
La qualité de l'extraction audio est affectée par :
Le rapport signal/bruit : quand la musique de fond est plus douce que la voix, la transcription est fiable. Quand la musique de fond domine (une esthétique TikTok courante), le signal vocal est plus difficile à isoler et la précision de transcription chute.
Le style de narration : certains créateurs narrent explicitement (« ajoutez deux cuillères à soupe de beurre »). D'autres narrent de manière décontractée (« mettez un peu de beurre, pas trop »). Le premier s'extrait bien ; le second s'extrait comme une approximation.
Rythme et clarté : les narrateurs qui parlent vite avec des accents régionaux ou des formes d'expression familières se transcrivent moins précisément qu'une narration mesurée et claire.
Combiner les trois couches en une recette
Une fois que l'extracteur a des lectures depuis la légende, l'OCR et l'audio, il doit les combiner en une seule recette cohérente. C'est là qu'un modèle de langage fait le travail de synthèse.
Le modèle examine les informations potentiellement chevauchantes ou contradictoires de toutes les sources et les résout :
- Si la légende dit « 2 tasses de farine » et l'audio dit « environ deux tasses », la valeur canonique est « 2 tasses ».
- Si la légende est vide, l'audio dit « une poignée de tomates cerises » et le texte à l'écran dit « 12 tomates cerises », le modèle utilise la valeur la plus précise.
- Si un ingrédient apparaît dans le texte à l'écran mais n'a jamais été mentionné dans la légende ou l'audio, il est inclus sur la seule base de l'OCR.
- Si deux sources se contredisent (la légende dit « 1 c. à soupe d'huile d'olive », l'audio dit « 3 cuillères à soupe »), le modèle choisit selon des indices contextuels — généralement la source la plus précise, ou celle qui apparaît le plus systématiquement.
La sortie est une recette structurée : titre, liste d'ingrédients avec quantités et unités, étapes ordonnées et un lien vers la source originale.
Pourquoi certaines extractions reviennent mieux que d'autres
Maintenant que le pipeline est clair, les modes d'échec prennent plus de sens :
Légende creuse + mauvais audio + superpositions stylisées : les trois couches sont dégradées simultanément. L'extracteur dispose de peu de données fiables et renvoie un résultat léger ou incomplet. C'est le pire cas — les TikToks très stylisés avec de la musique forte et sans légende.
Extractions basées sur la légende uniquement : quand la légende est riche et bien structurée, l'extracteur peut ignorer la vidéo et l'audio. Ce sont les plus rapides et les plus précises. Communes sur YouTube et pour les posts Instagram où les créateurs écrivent la recette complète.
Extractions dépendant de l'OCR : quand la légende est mince mais que le texte à l'écran est clair et bien rythmé, l'OCR fait le gros du travail. La précision dépend du choix de police et de la vitesse d'animation.
Extractions dépendant de l'audio : quand la légende et les superpositions sont pauvres mais que le créateur narre clairement, la transcription vocale fournit l'essentiel de la recette. La précision dépend de la clarté de la voix et du bruit de fond.
Comprendre cela vous aide à prédire le résultat : un TikTok très produit et esthétique est une extraction plus difficile qu'un tutoriel YouTube avec narration claire et description complète.
Ce que l'extraction ne fait pas
Quelques points qui méritent d'être clarifiés :
Elle n'hallucine pas les informations manquantes. Un extracteur de recettes responsable n'invente pas de quantités ou d'étapes qui n'étaient dans aucune des trois sources. Si la recette est genuinement incomplète dans la vidéo source, l'extraction sera incomplète aussi — elle n'inventera pas de valeurs plausibles.
Elle ne modifie pas la recette. L'extracteur structure ce qui est dans le matériau source. Il n'améliore pas, n'adapte pas, ne commente pas. Si le créateur a dit « assaisonnez à votre goût », l'étape dit « assaisonnez à votre goût ». Si il a dit une quantité précise, cette quantité est préservée.
Elle n'accède pas au contenu privé. Si un reel provient d'un compte privé, ou d'un post de groupe dont vous n'êtes pas membre, l'extracteur ne peut pas y accéder — et ne demandera pas vos identifiants de connexion pour essayer.
Quand l'IA se trompe : le workflow d'édition
Aucun pipeline n'est parfait. La précision d'extraction sur des sources claires et structurées (YouTube avec description complète, Instagram avec recette en légende) est très élevée. Sur des sources désordonnées (TikToks très stylisés avec musique forte), elle est plus faible.
Quand une extraction revient avec des erreurs :
- Ouvrez la recette dans ChefExtract. Chaque champ — titre, chaque ingrédient, chaque étape — est modifiable.
- Corrigez les erreurs. Ajoutez une mesure manquante, corrigez une quantité, complétez une étape partiellement capturée.
- Sauvegardez. La recette corrigée est maintenant permanente et précise.
Modifier une extraction partiellement correcte est presque toujours plus rapide que de transcrire depuis zéro. L'objectif de l'extraction n'est pas de remplacer le jugement humain — c'est de faire 80 à 90 % du travail pour que vous corrigiez plutôt que vous écriviez.
L'état de la technologie en 2026
L'IA multimodale — les modèles qui lisent simultanément le texte, l'image et l'audio — s'est améliorée de manière significative. Un extracteur de recettes construit aujourd'hui a accès à une précision de reconnaissance vocale qui aurait représenté une infrastructure commerciale de pointe il y a quelques années, et à des modèles de vision capables de lire le texte à l'écran avec une grande précision dans la plupart des conditions.
Les cas difficiles demeurent : textes superposés très rapides, musique de fond forte, absence de légende, et style visuel très produit. Ce ne sont pas des problèmes résolus. Les extracteurs honnêtes vous indiquent quand un résultat est incertain ; les malhonnêtes comblent les lacunes avec du contenu inventé qui semble plausible.
Si vous voulez voir comment l'extraction se comporte pour différents types de sources, parcourez des exemples de recettes extraites de vrais contenus culinaires. Ou essayez sur une vidéo que vous vouliez cuisiner :
Pour le workflow pratique sur chaque plateforme — Instagram, TikTok, YouTube, Facebook et Pinterest — voir le guide complet pour sauvegarder des recettes depuis les réseaux sociaux.
Essayez ChefExtract gratuitement
Enregistrez votre première recette en quelques secondes. Aucun compte requis.