8 июня 2026 г. · Автор: ChefExtract Team
Как ИИ извлекает рецепты из кулинарных видео
За кнопкой «вставь ссылку — получи рецепт» скрывается многоуровневый ИИ-конвейер, одновременно читающий подпись, видео и аудио. Вот что происходит при извлечении рецепта на самом деле.
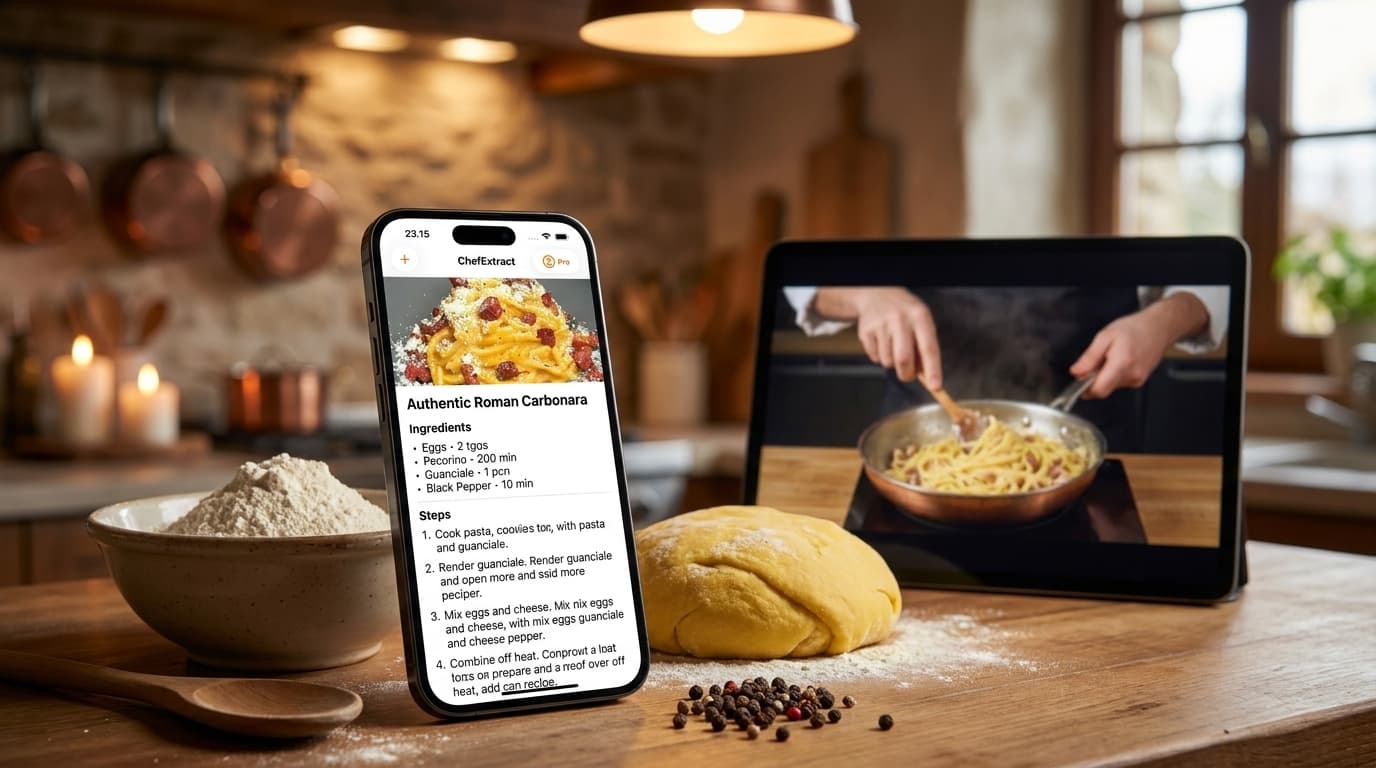
Вы вставляете ссылку из TikTok, нажимаете кнопку — и через 20 секунд получаете чистый список ингредиентов с пронумерованными шагами. Выглядит просто. Под поверхностью работает конвейер с несколькими отдельными этапами, каждый из которых решает свою часть задачи.
Понимание того, как это устроено, помогает пользоваться инструментом лучше — знать, когда ждать чистого результата, когда — результата, требующего правки, и почему одни видео извлекаются хорошо, а другие дают скудный результат.
Почему извлечение рецепта из видео сложнее, чем кажется
Извлечь рецепт из кулинарного видео — это не то же самое, что скопировать текст с сайта рецептов. На сайте есть структурированные данные: список ингредиентов в своём контейнере, шаги в своём контейнере, заголовок в теге heading. Экстрактор читает это за миллисекунды с высокой уверенностью.
В кулинарном видео такой структуры нет. Информация о рецепте разбросана по трём разным каналам одновременно:
- Слова, произносимые автором вслух («добавьте полчайной ложки соли»)
- Текстовые оверлеи, добавленные к видео («1/2 ч. л. соли», отображающиеся 0,4 секунды)
- Написанная подпись или описание («полный рецепт в профиле 🙏»)
Каждый канал сам по себе ненадёжен. Аудио может быть нечётким или заглушённым музыкой. Текстовые оверлеи могут быть стилизованы или мелькать слишком быстро. Подпись может быть пустой. Хороший экстрактор читает все три и объединяет их в связный рецепт.
Слой 1: подпись и описание
Первое, что читает экстрактор, — самое простое: текст. Подпись в Instagram или TikTok, описание на YouTube, текст поста на Facebook.
Для платформ, где авторы записывают рецепт текстом, — в первую очередь YouTube, где полное описание со списком ингредиентов является стандартом, — этого слоя часто достаточно. Экстрактор разбирает текст, определяет структуру списка ингредиентов (обычно паттерн «количество + единица + название ингредиента»), определяет шаги и собирает результат.
Когда подпись насыщенная, извлечение происходит быстро и очень точно — это разбор структурированного текста, а не интерпретация.
Когда подпись скудная (только хештеги, одна строка или вовсе пусто), экстрактор переходит к следующим слоям.
Слой 2: распознавание текста на экране (OCR)
Многие кулинарные авторы добавляют к видео текстовые оверлеи: количество ингредиентов, технические заметки, температурные значения, временные подсказки. «1 стакан муки.» «180°С.» «Щедро посолите.» Каждый из них отображается долю секунды и легко пропускается при просмотре видео, но ИИ-модель обрабатывает каждый кадр.
Это реализуется через оптическое распознавание символов (OCR) в сочетании с моделью компьютерного зрения, понимающей контекст прочитанного. Модель не просто извлекает буквы — она понимает, что «2 ст. л. оливкового масла» это запись ингредиента, а не случайный набор символов.
На точность OCR влияет несколько факторов:
Шрифт и контрастность: белый текст на тёмном фоне читается надёжно. Каллиграфические шрифты, яркие цвета на насыщенных фонах или текст с тяжёлой тенью читаются хуже.
Скорость анимации: текст, остающийся на экране 1–2 секунды, извлекается чисто. Текст, мелькающий 0,2 секунды, может быть пропущен или прочитан частично.
Тренды в оформлении оверлеев: в TikTok есть эстетика, где оверлеи с ингредиентами используют декоративные рукописные шрифты поверх кулинарного видео. Это выглядит красиво, но извлекается непоследовательно. Чем стилизованнее шрифт, тем ниже точность OCR.
Слой 3: транскрипция аудио
Третий источник — аудиодорожка, а именно закадровый комментарий автора. «Порежьте половину луковицы и обжарьте на оливковом масле около пяти минут» — полезная информация о рецепте, и зачастую это наиболее полный источник: автор, говорящий естественно, скорее всего упомянет все количества, чем запишет их все в виде текстовых оверлеев.
Модель «речь в текст» транскрибирует аудио, затем языковая модель разбирает транскрипт в поисках контента, относящегося к рецепту: упоминания ингредиентов, ссылки на количества, описания техник, временны́е указания.
На качество извлечения аудио влияет:
Отношение сигнал/шум: когда фоновая музыка тише голоса, транскрипция надёжна. Когда фоновая музыка доминирует (распространённая TikTok-эстетика), голос труднее изолировать и точность транскрипции падает.
Стиль подачи: одни авторы чётко проговаривают («добавьте две столовые ложки сливочного масла»). Другие — размыто («закиньте немного масла, не слишком много»). Первое хорошо извлекается; второе — как приблизительное.
Темп и чёткость: быстроговорящие авторы с региональным акцентом или разговорной речью транскрибируются менее точно, чем размеренное и чёткое повествование.
Объединение трёх слоёв в рецепт
Получив данные из подписи, OCR и аудио, экстрактор должен объединить их в единый связный рецепт. Здесь языковая модель выполняет синтез.
Модель смотрит на потенциально перекрывающуюся или противоречивую информацию из разных источников и разрешает её:
- Если в подписи «2 стакана муки», а в аудио «примерно два стакана», каноническое значение — «2 стакана».
- Если подпись пустая, аудио говорит «горсть черри», а оверлей показывает «12 черри-помидоров» — модель использует более конкретное значение.
- Если ингредиент есть в тексте оверлея, но ни разу не упоминается в подписи или аудио, он включается только на основе OCR.
- Если два источника противоречат друг другу (в подписи «1 ст. л. оливкового масла», в аудио «3 столовые ложки»), модель выбирает на основе контекстных подсказок — обычно более конкретный источник или тот, что встречается последовательнее.
Результат — структурированный рецепт: название, список ингредиентов с количествами и единицами, упорядоченные шаги и ссылка на оригинальный источник.
Почему одни извлечения получаются лучше других
Теперь, когда конвейер понятен, причины сбоев становятся очевидными:
Скудная подпись + плохое аудио + стилизованные оверлеи: все три слоя деградированы одновременно. Экстрактору не с чем работать, и он возвращает скудный или неполный результат. Это худший случай — сильно стилизованные TikTok-ролики с громкой музыкой и без подписи.
Только подпись: когда подпись насыщенная и хорошо структурированная, экстрактор может полностью игнорировать видео и аудио. Это самые быстрые и точные извлечения. Типично для YouTube и постов в Instagram, где авторы пишут полный рецепт.
Зависимость от OCR: когда подпись скудная, но текст на экране чёткий и хорошо темпованный, OCR несёт основную нагрузку. Точность зависит от выбора шрифта и скорости анимации.
Зависимость от аудио: когда подпись и оверлеи скудные, но автор чётко проговаривает, транскрипция речи даёт основную часть рецепта. Точность зависит от чёткости голоса и фонового шума.
Это помогает предсказать результат: насыщенный визуальными эффектами TikTok — более сложное извлечение, чем YouTube-туториал с чётким закадровым голосом и полным описанием.
Чего извлечение не делает
Несколько вещей, которые стоит прояснить:
Оно не выдумывает недостающую информацию. Ответственный экстрактор рецептов не угадывает количества или шаги, которых не было ни в одном из трёх источников. Если рецепт в исходном видео неполный, извлечение тоже будет неполным — оно не придумывает правдоподобные значения.
Оно не изменяет рецепт. Экстрактор структурирует то, что есть в исходном материале. Он не улучшает, не адаптирует и не редактирует. Если автор сказал «приправьте по вкусу», в шаге так и будет написано. Если было указано конкретное количество, оно сохраняется.
Оно не получает доступ к закрытому контенту. Если Reel из приватного аккаунта или пост в группе, в которой вы не состоите, экстрактор не может его получить — и не будет запрашивать ваши учётные данные для попытки.
Когда ИИ ошибается: работа с редактированием
Ни один конвейер не идеален. Точность на чётких структурированных источниках (YouTube с полным описанием, Instagram с рецептом в подписи) очень высокая. На запутанных источниках (стилизованные TikTok с громкой музыкой) — ниже.
Когда извлечение содержит ошибки:
- Откройте рецепт в ChefExtract. Каждое поле — название, каждый ингредиент, каждый шаг — редактируется.
- Исправьте ошибки. Добавьте недостающую граммовку, скорректируйте количество, дополните шаг, который был захвачен частично.
- Сохраните. Исправленный рецепт теперь постоянный и точный.
Редактировать частично правильное извлечение почти всегда быстрее, чем транскрибировать с нуля. Цель извлечения — не заменить человеческое суждение, а взять на себя 80–90% работы, чтобы вы исправляли, а не писали.
Состояние технологии в 2026 году
Мультимодальный ИИ — модели, одновременно читающие текст, изображение и аудио, — существенно улучшился. Экстрактор рецептов, созданный сегодня, имеет доступ к точности распознавания речи, которая несколько лет назад была уровнем корпоративной инфраструктуры, и к моделям компьютерного зрения, читающим текст на экране с высокой точностью в большинстве условий.
Сложные случаи по-прежнему остаются: очень быстро мелькающие оверлеи, громкая фоновая музыка, отсутствие подписи, высокопроизводственный визуальный стиль. Это нерешённые задачи. Честные экстракторы сообщают, когда результат ненадёжен; нечестные заполняют пробелы правдоподобно звучащим, но выдуманным контентом.
Если хотите посмотреть, как работает извлечение на разных типах источников, просмотрите примеры рецептов, извлечённых из реального кулинарного контента. Или попробуйте на видео, которое давно хотите приготовить:
О практическом процессе для каждой платформы — Instagram, TikTok, YouTube, Facebook и Pinterest — читайте в полном руководстве по сохранению рецептов из социальных сетей.
Попробуйте ChefExtract бесплатно
Сохраните первый рецепт за несколько секунд. Аккаунт не нужен.